Che cosa succede se si prova a prevedere dove atterrerà il prossimo «elettrone» di una frangia di interferenza, usando come sorgente un vero computer quantistico? Abbiamo messo alla prova l’idea su hardware reale, con 17 qubit superconduttori, e il risultato più interessante non riguarda la frangia: riguarda un piccolo bias della macchina che si è fatto notare nei numeri.
Come è fatto l’esperimento
L’esperimento ha due parti. Nella prima, un circuito a un solo qubit si comporta come un interferometro a due cammini: una rotazione Ry fa da «beamsplitter», una rotazione Rz codifica la differenza di fase (l’equivalente di una differenza di cammino ottico) e una porta H ricombina i due cammini. Il circuito viene eseguito una volta per ciascuna di 21 posizioni x comprese tra −1 e +1, e la probabilità di misurare lo stato |1⟩ è letta direttamente dai conteggi dell’hardware, non calcolata a tavolino.
Nella seconda parte un circuito ancora più semplice, fatto solo di porte H seguite da misura, produce bit casuali genuinamente quantistici. Quei bit vengono trasformati, con il campionamento a trasformata inversa, in 4000 posizioni continue sulla densità interpolata dai 21 punti della prima parte. Un predittore basato su stima di densità a kernel (KDE) osserva la sequenza elettrone dopo elettrone e cerca di stimare dove cadrà il successivo, usando solo il passato.
Le domande erano due: le misure quantistiche successive sono davvero prive di «memoria»? E quanto può avvicinarsi un modello statistico al limite teorico, quello di un oracolo che conosce la distribuzione vera?
La distribuzione misurata sul chip
La probabilità normalizzata misurata nelle 21 posizioni. Il picco dominante è in x = +0,2.
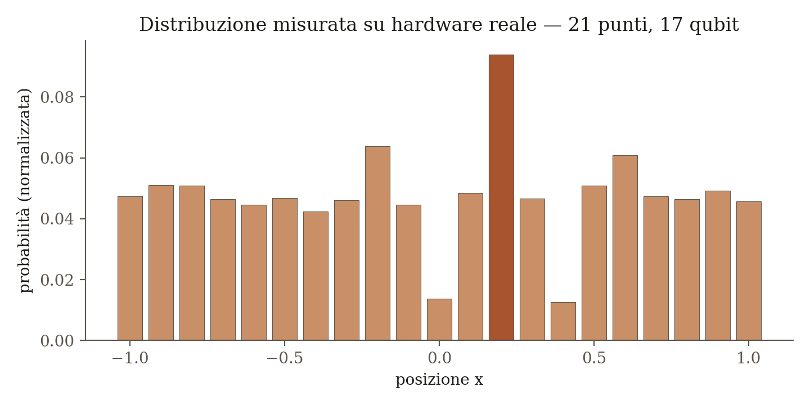
La distribuzione ha una struttura netta: un picco dominante in x = +0,2, due avvallamenti quasi nulli vicino a x = 0 e a x = +0,4, e un fondo abbastanza piatto altrove. In questa sessione non compaiono anomalie: tutti i punti stanno nell’intervallo atteso, compreso x = −0,4, che in sessioni precedenti aveva mostrato un valore anomalo. Il picco in +0,2 è stabile e riproducibile tra sessioni diverse.
4000 «elettroni» da monete quantistiche
Le 4000 posizioni campionate dal computer quantistico (barre) seguono la densità interpolata dai punti della prima parte (linea).
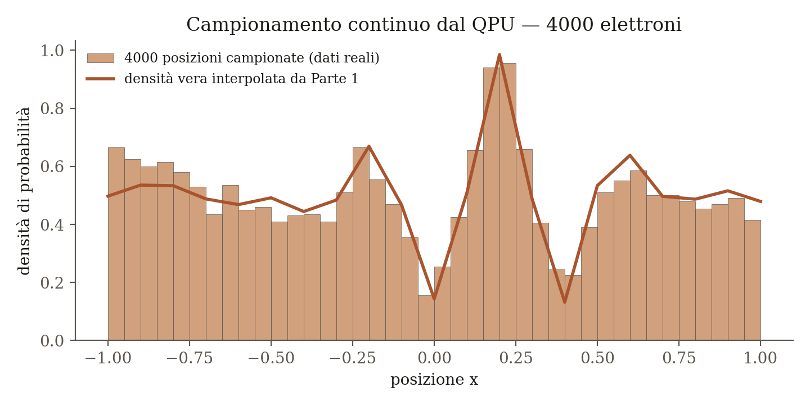
Le 4000 posizioni continue seguono visibilmente la densità della prima parte, picco compreso. Sul fronte della «memoria», l’autocorrelazione tra elettroni successivi vale 0,0125, compatibile con zero entro l’errore atteso (circa 0,016): nessuna correlazione reale tra un elettrone e il successivo.
Quanto in fretta impara il predittore
Il gap dall’oracolo al crescere della finestra N (scala logaritmica) e, tratteggiato, il riferimento teorico N^(−2/5).
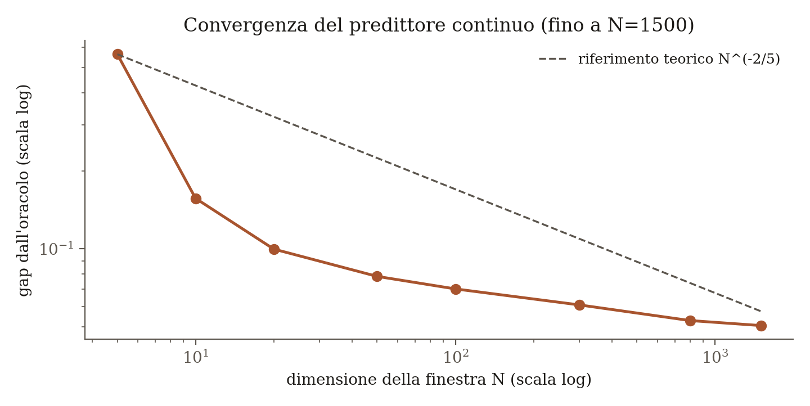
Come misura di qualità usiamo il «gap» dall’oracolo, cioè quanto la stima resta indietro rispetto a chi conosce la densità vera. Con appena 5 osservazioni il gap è 0,56; con 10 scende a 0,16, con 100 a 0,07 e con 1500 a circa 0,051. Resta sopra zero ma continua a scendere. Il fit log-log dà un esponente attorno a −0,35/−0,4, coerente con il tasso teorico dei kernel non parametrici, più lento di quello di un semplice istogramma. Per orientarsi: la log-densità dell’oracolo è −0,6458, quella di una distribuzione uniforme (il modello che non sa nulla) è −0,6931.
A che cosa serve, allora, un predittore?
Il singolo elettrone resta imprevedibile per costruzione: i campioni sono indipendenti e nemmeno l’oracolo può fare meglio dell’entropia della distribuzione. Quello che si può fare è rispondere a domande del tipo: con che probabilità il prossimo valore supererà una soglia, starà sotto un’altra, oppure cadrà tra le due? E, soprattutto, quanto ci si può fidare di quella stima.
L’incertezza si quantifica con un approccio bayesiano: con un prior uniforme, se k campioni su N cadono nella regione, la probabilità incognita ha distribuzione a posteriori Beta(k+1, N−k+1), da cui si ricava un intervallo di credibilità al 95%. Per probabilità intorno a 0,25 l’intervallo è largo circa ±2 punti percentuali con N = 1500 e circa ±1,3 con N = 4000.
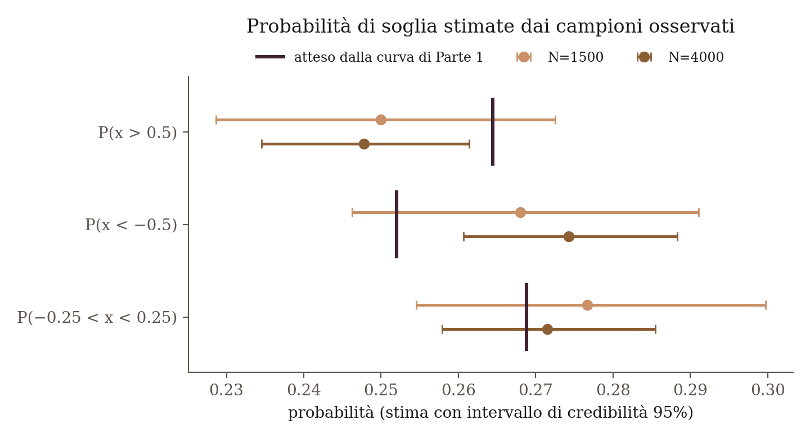
Tre probabilità di soglia stimate dai campioni, con intervallo di credibilità al 95%. Il segmento scuro è il valore atteso dalla curva della prima parte.
Con N = 1500 tutti e tre gli intervalli contengono il valore atteso dalla curva misurata nella prima parte. Con N = 4000 gli intervalli si stringono e due su tre lo mancano, con uno scarto sistematico: troppi campioni a sinistra (la probabilità di x < −0,5 è stimata a 0,274 contro 0,252 attesi) e troppo pochi a destra (0,248 contro 0,265 per x > 0,5). La probabilità di cadere tra −0,25 e +0,25 resta invece in linea, a circa 0,27.
Il colpevole: monete non del tutto equilibrate
Se le posizioni seguissero esattamente la curva della prima parte, la loro trasformata probabilistica u = F(x) sarebbe uniforme tra 0 e 1. Nell’ultima sessione la media di u è 0,4868 contro un valore atteso di 0,5000 ± 0,0046, e il test di Kolmogorov-Smirnov dà p ≈ 0,008: la deviazione è statisticamente significativa.
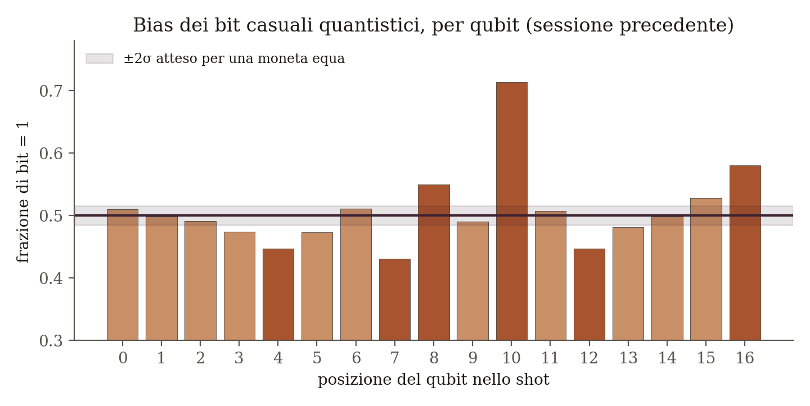
Frazione di bit pari a 1 per ogni posizione del qubit nello shot (sessione precedente). La banda indica ±2σ atteso per una moneta equa.
La spiegazione più plausibile è che i bit casuali quantistici, generati con una porta H seguita da misura, non siano equiprobabili. In una sessione precedente, di cui abbiamo i bit grezzi, la frazione di 1 varia da qubit a qubit tra 0,43 e 0,71, quando per una moneta equa ci si aspetterebbe 0,50 ± 0,008. Per l’ultima sessione i bit grezzi non sono disponibili, quindi lì la spiegazione resta un’inferenza.
Per prevedere il comportamento di questa macchina, dunque, le stime empiriche restano il riferimento giusto: descrivono la sorgente reale, bias compreso, e si discostano di circa 1-2 punti percentuali dalla curva ideale. Non è un errore del predittore, è un’informazione sull’hardware. Con due limiti: le stime valgono per la sessione e la calibrazione in cui sono state raccolte, perché l’hardware deriva nel tempo; e l’indipendenza tra elettroni è stata verificata solo con l’autocorrelazione a passo 1, che non esclude correlazioni residue tra qubit vicini dello stesso shot.
Che cosa dimostra, e che cosa no
L’esperimento mostra che l’indipendenza tra misure quantistiche successive, un postulato della meccanica quantistica standard, si può verificare empiricamente su hardware reale in modo ripetibile. Mostra anche, su dati reali e non simulati, alcune proprietà genuine della stima statistica: la diversa velocità di convergenza tra stimatori parametrici e non parametrici, il compromesso tra bias e varianza a finestre intermedie e la necessità di correzioni quando si stima una densità su un dominio limitato.
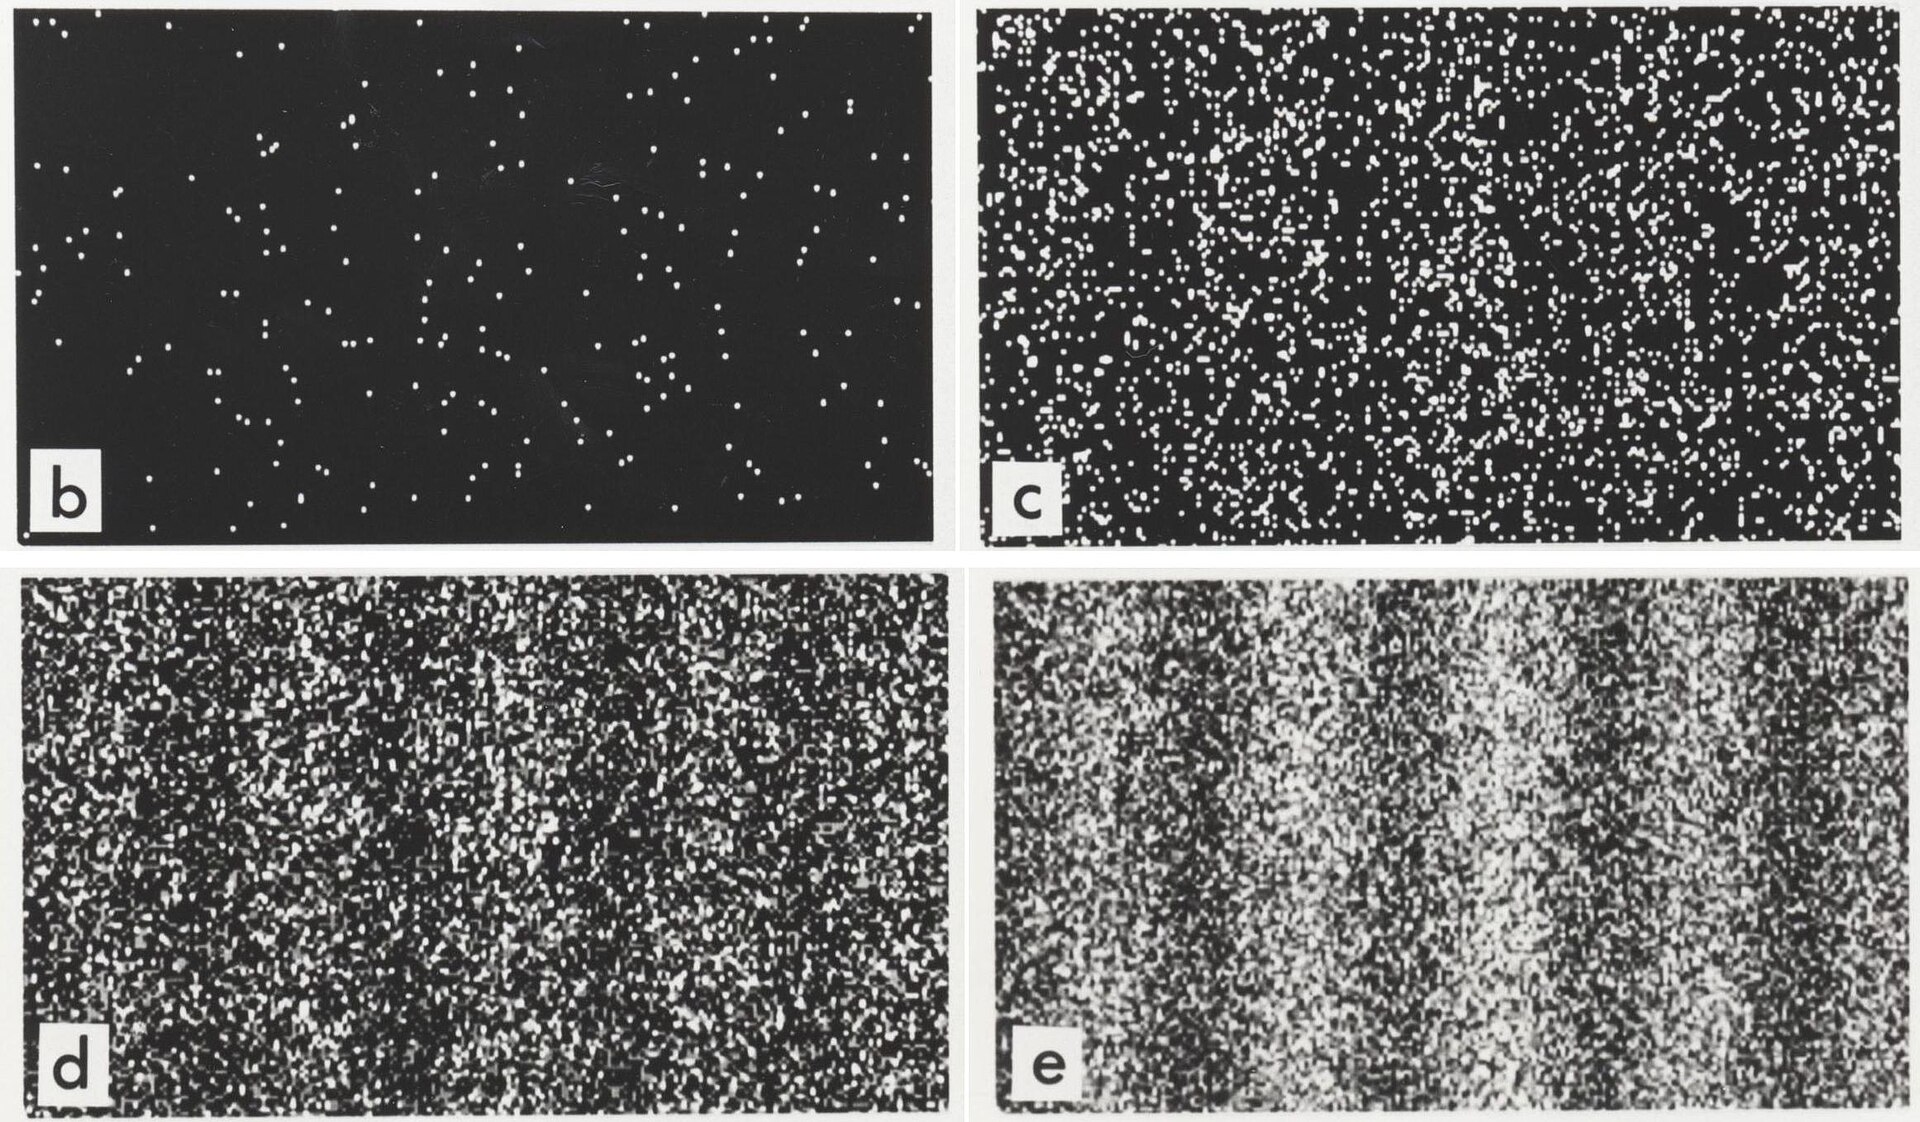
Non è invece una replica dell’esperimento di Tonomura. Lui faceva diffrangere elettroni fisici attraverso un biprisma elettronico, nello spazio reale. Qui Tonomura è stata soltanto l’ispirazione per la geometria del circuito, scelta per assomigliare a una frangia con inviluppo, ma la grandezza misurata è la statistica di un singolo qubit superconduttore. È un’analogia formale, non la stessa fisica.
E adesso: Gaussiana o Cauchy?
Per il prossimo passo ci sono due candidate. La gaussiana troncata su [−1, 1] sarebbe un caso di controllo pulito: liscia e nota analiticamente, permetterebbe di verificare se esponente di convergenza e correzione di bordo si comportano come da manuale, senza le complicazioni del picco netto e dei pozzi della frangia attuale.
La Cauchy è metodologicamente più interessante, perché è uno stress test di un punto debole noto: ha code pesanti e varianza non definita, mentre la regola con cui si sceglie la larghezza del kernel presuppone una forma vicina alla gaussiana. Servirebbe capire dove e come l’approccio attuale smette di funzionare. Resta da decidere se troncare la distribuzione, perdendo però proprio le code pesanti che la rendono interessante, o ridisegnare il dominio.